Intégration communautaire OpenAI, gratuite et open source
Faites tourner l’assistant Gladys sur les modèles GPT d’OpenAI avec votre clé d’API OpenAI.
Publiée par William-De71
- Appareils
- Version 0.1.0
- Nécessite Gladys >=5.3.0
- ★ 0
Présentation
Cette intégration fait tourner l’assistant de Gladys sur les modèles GPT d’OpenAI, via l’API officielle d’OpenAI (API Responses) et votre propre clé d’API. Une fois choisie dans Paramètres → Intelligence artificielle, chaque requête d’IA de Gladys part chez OpenAI : le chat et les appareils qu’il pilote, les scènes qu’il crée, l’action de scène « demander à l’IA » et le résumé hebdomadaire. Elle fonctionne sans compte Gladys Plus : vous payez OpenAI directement, à l’usage.
Elle ajoute aussi deux déclencheurs de scène (l’assistant est en erreur, l’assistant répond de nouveau) et un widget de tableau de bord de votre consommation.
Non affiliée à OpenAI. Pas encore testée avec une vraie clé OpenAI : vos retours sont bienvenus.
Prérequis
- Gladys Assistant 5.3.0 ou plus récent.
- Un compte sur la plateforme OpenAI avec des crédits prépayés (Billing), et une clé d’API : API keys, Create new secret key (une clé de projet suffit).
- Coûts : facturation au jeton. Avec les modèles par défaut, un échange du chat coûte une fraction de centime ; les jetons de raisonnement comptent comme sortie. Fixez un budget mensuel et des plafonds de dépenses dans Limits : l’intégration s’arrête alors proprement quand ils sont atteints.
- Vos données : OpenAI n’entraîne pas ses modèles sur les données de l’API sauf accord de votre part. L’intégration envoie chaque requête sans stockage (
store: false), mais OpenAI garde des journaux de surveillance des abus jusqu’à 30 jours. - Ce qui sort de chez vous : chaque message du chat, l’historique, les outils que Gladys propose et leurs résultats (l’état des appareils que le modèle consulte) et les images du chat partent chez OpenAI en HTTPS. Les réponses pilotent vos appareils et créent des scènes.
Configuration
| Champ ou bouton | Par défaut | Rôle |
|---|---|---|
| Clé d’API OpenAI | — | Obligatoire. Jamais réaffichée, jamais journalisée |
| Modèle du chat | GPT-6.1 Terra | Répond au chat, crée les scènes, rédige le résumé hebdomadaire |
| Modèle du routeur | GPT-6 Luna | Trie chaque message avant la réponse et doit répondre en moins de 20 secondes |
| Identifiant de l’autre modèle | — | Seulement quand un modèle est sur « Autre modèle » : l’identifiant exact (il doit appeler des outils, Responses) |
| Raisonnement du modèle du chat | Faible | Plus de raisonnement, de meilleures scènes, des réponses plus lentes et plus chères |
| Longueur maximale d’une réponse (jetons) | 16000 | Raisonnement compris ; OpenAI conseille 25000 pour essayer un raisonnement élevé |
| Tester la connexion | — | Une réponse courte de chaque modèle avec son temps ; consomme quelques jetons |
Le statut de l’écran de configuration indique si OpenAI accepte la clé et les deux modèles, sans consommer de jeton. Lire un modèle ne prouve pas que le projet peut payer (plus de crédit, plafond de dépenses) : Tester la connexion, si.
Utilisation
- Intégrations → OpenAI → Configuration : collez la clé d’API, gardez les modèles par défaut, appuyez sur Tester la connexion.
- Paramètres → Intelligence artificielle : choisissez OpenAI.
- Parlez à Gladys dans le chat : « allume le salon », « quelle température dans la chambre ? », « crée une scène qui ferme les volets au coucher du soleil ».
Choisir les modèles
Prix par million de jetons, entrée / sortie, au 5 novembre 2026 :
- GPT-6.1 Terra (par défaut pour le chat, 1 $ / 5 $) : rapide, bon pour appeler des outils et pour rédiger clairement.
- GPT-6.1 Sol (2 $ / 10 $) : proche d’Astra pour les demandes complexes.
- GPT-6 Astra (10 $ / 50 $) : le plus capable, pour de longues descriptions de scènes.
- GPT-6 Luna (routeur par défaut, 0,10 $ / 0,50 $) : le plus rapide et le moins cher ; moins fiable pour créer des scènes.
- GPT-5.6 Terra et GPT-5.6 Luna : la génération précédente, toujours prise en charge.
- Autre modèle : un modèle plus récent ou une version datée. S’il refuse l’effort de raisonnement, l’intégration l’envoie ensuite sans.
GPT-6.1 Sol et GPT-6 Astra ne peuvent pas arrêter de raisonner : Aucun devient faible pour eux. Le routeur utilise toujours le moins de raisonnement que son modèle accepte.
Widget de tableau de bord
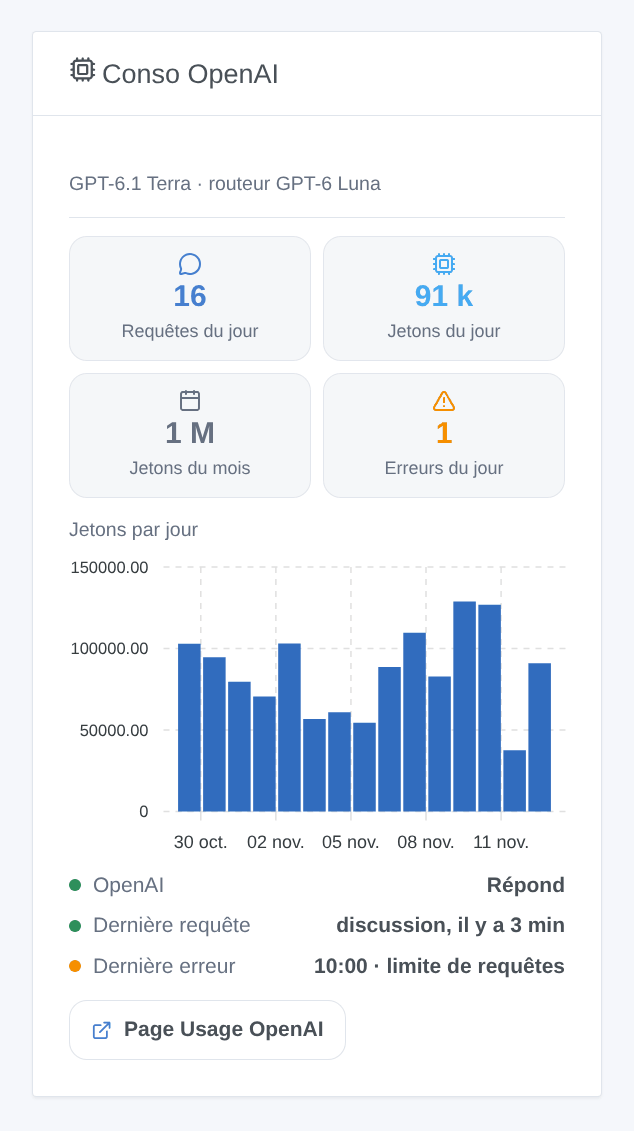
Le widget Conso OpenAI affiche les requêtes et jetons du jour, les jetons du mois, les erreurs du jour, les jetons par jour sur 30 jours, si OpenAI répond, la dernière requête et la dernière erreur. Il compte ce que Gladys a demandé, raisonnement compris ; la page Usage de la plateforme OpenAI reste la référence pour la facture.
Scènes
- Déclencheur « OpenAI : l’assistant est en erreur » : une fois par panne (clé refusée, crédits ou plafond de dépenses, limite de requêtes, modèle indisponible, API injoignable, trop lent, erreur OpenAI), avec le type, le message, la requête et le modèle.
- Déclencheur « OpenAI : l’assistant répond de nouveau » : la première réponse après une panne, avec les minutes de panne.
Exemples : quand l’assistant est en erreur à cause des crédits ou du plafond de dépenses, envoyer un message Telegram à l’administrateur ; quand il répond de nouveau, en envoyer un autre avec les minutes de panne.
Il n’y a pas d’action de recherche web : OpenAI impose d’afficher les résultats web avec leurs sources en liens visibles et cliquables, ce qu’une notification de scène ne peut pas garantir.
Dépannage
- « OpenAI a refusé la clé d’API » : recopiez la clé depuis la page API keys ; une clé révoquée donne le même message. Le même message apparaît quand Gladys tourne dans un pays qu’OpenAI ne dessert pas.
- « OpenAI refuse de faire tourner … : plus de crédit ou plafond de dépenses atteint » : ajoutez des crédits dans Billing, ou relevez le budget dans Limits. Attendre ne sert à rien : l’intégration ne réessaie pas.
- « Limite de requêtes atteinte » : les limites dépendent du palier d’usage du compte et montent avec vos dépenses. Un échange du chat fait au moins deux requêtes.
- « … n’est pas disponible pour cette clé d’API » : le modèle n’existe pas, a été arrêté, ou le projet n’y a pas accès ; choisissez-en un autre.
- Le chat répond sans rien faire : essayez GPT-6.1 Terra ou 6.1 Sol avec un raisonnement faible ou moyen ; GPT-6 Luna est moins fiable avec beaucoup d’outils.
- « The answer was cut at max_tokens » : augmentez la longueur maximale d’une réponse, ou baissez le raisonnement.
- « … refused to answer » ou « content_filter » : les systèmes de sécurité d’OpenAI ont bloqué la demande ou la réponse ; reformulez-la.
- Journaux : Paramètres → Supervision, les journaux de l’intégration. Ne partagez jamais votre clé d’API.
Paramètres de configuration
Voici les paramètres demandés par OpenAI dans son écran de configuration dans Gladys.
| Paramètre | Type | Obligatoire | Description |
|---|---|---|---|
| Pour commencer | section | Non | L’assistant répond via l’API OpenAI, facturée à l’usage sur votre compte OpenAI (crédits prépayés) : créez une clé d’API sur platform.openai.com, collez-la ci-dessous, puis choisissez cette intégration dans Paramètres, Intelligence artificielle. OpenAI voit alors chaque message du chat, l’historique, l’état des appareils qu’il consulte et les images du chat. |
| Coûts et confidentialité | section | Non | OpenAI n’entraîne pas ses modèles sur les données de l’API sauf accord de votre part. Les requêtes partent sans stockage, mais OpenAI garde des journaux de surveillance des abus jusqu’à 30 jours. Chaque message du chat passe aussi par le routeur : fixez un budget mensuel et des plafonds dans la page Limits de la plateforme. |
| Clé d’API OpenAI | secret | Oui | Créée sur platform.openai.com, dans API keys (une clé de projet suffit). Elle reste dans Gladys, n’est plus jamais affichée ni journalisée. |
| Modèle du chat | select | Oui | Répond au chat, crée les scènes et rédige le résumé hebdomadaire. 6.1 Terra équilibre qualité et coût ; 6.1 Sol et 6 Astra sont plus forts mais coûtent 2 et 10 fois plus ; 6 Luna est le moins cher mais moins fiable pour créer des scènes. |
| Modèle du routeur | select | Oui | Trie chaque message du chat avant la réponse, et doit répondre en moins de 20 secondes : un petit modèle rapide convient le mieux. |
| Identifiant de l’autre modèle | string | Non | Seulement pour « Autre modèle » : l’identifiant exact d’un modèle OpenAI (un modèle plus récent, une version datée…). Il doit savoir appeler des fonctions via l’API Responses. |
| Raisonnement du modèle du chat | select | Oui | Plus de raisonnement donne de meilleures scènes mais des réponses plus lentes et plus chères. 6.1 Sol et 6 Astra ne peuvent pas l’arrêter : « Aucun » devient faible pour eux. |
| Longueur maximale d’une réponse (jetons) | number | Non | Le raisonnement compte aussi dedans. Augmentez-la si les journaux indiquent qu’une réponse a atteint max_tokens ; OpenAI conseille 25000 pour essayer un raisonnement élevé. |
Comment installer OpenAI dans Gladys
- Dans Gladys, ouvrez Intégrations : OpenAI apparaît dans le catalogue, aux côtés des intégrations natives, avec un badge communautaire.
- Cliquez sur Installer. Gladys télécharge l'image Docker (
ghcr.io/william-de71/gladys-openai:0.1.0), la démarre dans un bac à sable isolé du cœur, et génère l'interface de l'intégration (appareils, découverte et configuration). - Ouvrez l'écran Configuration de l'intégration, remplissez les paramètres, puis enregistrez.
- Vous pouvez aussi l'installer directement depuis l'URL de son dépôt : https://github.com/William-De71/gladys-openai.
OpenAI nécessite Gladys >=5.3.0. Le catalogue dans Gladys se rafraîchit toutes les heures : une nouvelle version est donc disponible au plus tard une heure après sa sortie.
Vous n'utilisez pas encore Gladys ? C'est gratuit et open source : suivez le guide d'installation pour démarrer.
À propos des intégrations externes
OpenAI est une intégration externe : une intégration communautaire empaquetée dans un conteneur Docker et publiée sur GitHub, que Gladys installe en un clic et exécute dans un bac à sable isolé de son cœur. Elle est publiée et maintenue par William-De71, et non par l'équipe cœur de Gladys.
- Parcourir toutes les intégrations, natives et communautaires
- Créer et publier votre propre intégration externe
- Code source sur GitHub — source de cette documentation