Integración domótica Google Gemini, gratuita y de código abierto
Haga funcionar el asistente de Gladys con Google Gemini y su clave de API de Google AI Studio.
Publicado por William-De71
- Dispositivos
- Versión 0.1.0
- Requiere Gladys >=5.3.0
- ★ 0
Presentación
Esta integración hace funcionar el asistente de Gladys con Google Gemini, a través de la API oficial de Gemini y su propia clave de API de Google AI Studio. Una vez elegida en Ajustes → Inteligencia artificial, todas las solicitudes de IA de Gladys van a Gemini: el chat y los dispositivos que controla, las escenas que crea, la acción de escena «preguntar a la IA» y el resumen semanal. Funciona con o sin cuenta Gladys Plus, y el nivel gratuito de la API de Gemini basta para empezar.
También añade dos desencadenantes de escena (el asistente falla, el asistente vuelve a responder) y un widget de panel con su consumo.
No afiliada a Google. Todavía no probada con una clave real de Gemini: sus comentarios son bienvenidos.
Requisitos previos
- Gladys Assistant 5.3.0 o posterior.
- Una cuenta de Google y una clave de API de Gemini: Google AI Studio, Create API key.
- Nivel gratuito: suficiente para una casa, con límites bajos por minuto y por día (visibles en AI Studio, Rate limit); Gemini 4 Argon no está incluido. Con una cuenta de facturación (nivel de pago): límites más altos, todos los modelos, facturación por token.
- Sus datos: fuera del Espacio Económico Europeo, Suiza y el Reino Unido, Google puede usar las solicitudes del nivel gratuito para mejorar sus productos, y algunas personas pueden leerlas. En esos países, y en cualquier lugar con una cuenta de facturación, no es así. La integración envía cada solicitud con el registro desactivado (
store: false). - Lo que sale de su casa: cada mensaje del chat, el historial, las herramientas que ofrece Gladys y sus resultados (el estado de los dispositivos que Gemini consulta) y las imágenes del chat van a Google por HTTPS. Las respuestas de Gemini controlan sus dispositivos y crean escenas.
Configuración
| Campo o botón | Por defecto | Significado |
|---|---|---|
| Clave de API de Gemini | — | Obligatoria. Nunca se vuelve a mostrar ni se registra |
| Modelo del chat | Gemini 3.8 Flash | Responde al chat, crea escenas, redacta el resumen semanal |
| Modelo del enrutador | Gemini 3.5 Flash-Lite | Clasifica cada mensaje antes de la respuesta y debe contestar en menos de 20 segundos |
| Identificador del otro modelo | — | Solo si un modelo está en «Otro modelo»: el identificador exacto (llamada a herramientas) |
| Razonamiento del modelo del chat | Medio | Más razonamiento, mejores escenas, respuestas más lentas y caras |
| Longitud máxima de una respuesta (tokens) | 16000 | Razonamiento incluido; Google aconseja 32768 para Gemini 4 Argon |
| Probar la conexión | — | Una respuesta corta de cada modelo con su tiempo; consume algunos tokens |
El estado de la pantalla de configuración indica si Google acepta la clave y los dos modelos, sin consumir tokens. Leer un modelo no prueba que su proyecto pueda generar (nivel gratuito no disponible, facturación por configurar): Probar la conexión lo comprueba.
Uso
- Integraciones → Google Gemini → Configuración: pegue la clave de API, mantenga los modelos por defecto y pulse Probar la conexión.
- Ajustes → Inteligencia artificial: elija Google Gemini.
- Hable con Gladys en el chat: «enciende el salón», «¿qué temperatura hace en el dormitorio?», «crea una escena que cierre las persianas al atardecer».
Elegir los modelos
- Gemini 3.8 Flash (por defecto para el chat): el modelo más capaz del nivel gratuito, bueno para llamar a herramientas y crear escenas.
- Gemini 4 Argon: el más capaz, solo para un proyecto con facturación.
- Gemini 3.6 Flash: el Flash anterior, todavía compatible.
- Gemini 3.5 Flash-Lite (enrutador por defecto) y Gemini 3.1 Flash-Lite: rápidos y baratos; menos fiables para crear escenas. Google prevé retirar 3.1 Flash-Lite en mayo de 2027.
- Otro modelo: un modelo de Gemini más reciente o una versión preliminar. Si rechaza el nivel de razonamiento, la integración lo envía sin él a partir de entonces.
Gemini siempre razona un poco: mínimo es lo menos, y Gemini 3.8 Flash y Gemini 4 Argon empiezan en bajo. El enrutador usa siempre el razonamiento más bajo que acepta su modelo.
Widget de panel
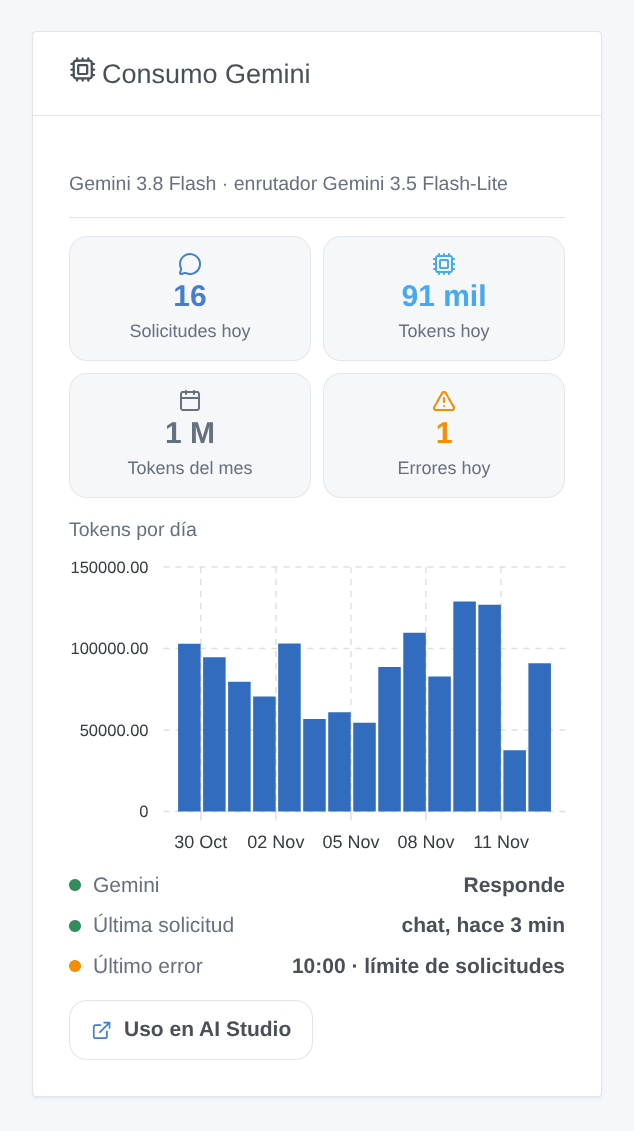
El widget Consumo Gemini muestra las solicitudes y tokens del día, los tokens del mes, los errores del día, los tokens por día durante 30 días, si Gemini responde, la última solicitud y el último error. Cuenta lo que Gladys ha pedido, razonamiento incluido; Google AI Studio sigue siendo la referencia para la factura.
Escenas
- Desencadenante «Gemini: el asistente falla»: una vez por fallo (clave rechazada, facturación o nivel gratuito, límite de solicitudes, modelo no disponible, API inaccesible, demasiado lento, error de Gemini), con el tipo, el mensaje, la solicitud y el modelo.
- Desencadenante «Gemini: el asistente vuelve a responder»: la primera respuesta tras un fallo, con los minutos de fallo.
Ejemplos: cuando el asistente falla por el límite de solicitudes, enviar un mensaje de Telegram al administrador; cuando vuelve a responder, enviar otro con los minutos de fallo.
No hay acción de búsqueda web: las condiciones de la fundamentación con la Búsqueda de Google exigen mostrar las sugerencias de búsqueda de Google con cada respuesta, algo que una notificación de escena no puede hacer.
Solución de problemas
- «Google ha rechazado la clave de API»: vuelva a copiar la clave desde Google AI Studio; una clave eliminada, o señalada como filtrada, da el mismo mensaje.
- «Google se niega a ejecutar … para este proyecto»: el nivel gratuito no está disponible para este proyecto, o la cuenta de facturación requiere atención; abra Google AI Studio, Billing.
- «Se ha alcanzado el límite de solicitudes»: el nivel gratuito admite pocas solicitudes por minuto y por día (por proyecto, se reinician a medianoche, hora del Pacífico). Un turno de chat hace al menos dos solicitudes. Espere, elija un enrutador más ligero o vincule una cuenta de facturación.
- «… no está disponible para esta clave de API»: el modelo no existe o ha sido retirado; elija otro.
- El chat responde sin hacer nada: pruebe Gemini 3.8 Flash con razonamiento medio; los Flash-Lite son menos fiables con muchas herramientas.
- «The answer was cut at max_tokens» (mensaje en inglés): aumente la longitud máxima de una respuesta o baje el razonamiento.
- «Gemini stopped the answer (SAFETY)» (mensaje en inglés): los filtros de Google han bloqueado la solicitud o la respuesta; reformúlela.
- Registros: Ajustes → Supervisión, registros de la integración. Nunca comparta su clave de API.
Parámetros de configuración
Estos son los parámetros que Google Gemini te pide en su pantalla de configuración en Gladys.
| Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
| Primeros pasos | section | No | Gemini responde a través de la API de Gemini de Google: cree una clave de API en Google AI Studio (nivel gratuito, o de pago con una cuenta de facturación), péguela abajo y luego elija esta integración en Ajustes, Inteligencia artificial. Gemini ve entonces cada mensaje del chat, el historial, el estado de los dispositivos que consulta y las imágenes del chat. |
| Nivel gratuito y privacidad | section | No | Fuera del Espacio Económico Europeo, Suiza y el Reino Unido, Google puede usar las solicitudes del nivel gratuito para mejorar sus productos, y algunas personas pueden leerlas. En esos países, y en cualquier lugar con una cuenta de facturación, no es así. El nivel gratuito tiene límites bajos por minuto y por día, y Gemini 4 Argon requiere facturación. |
| Clave de API de Gemini | secret | Sí | Creada en Google AI Studio, en Get API key. Se queda en Gladys y nunca se vuelve a mostrar ni se registra. |
| Modelo del chat | select | Sí | Responde al chat, crea las escenas y redacta el resumen semanal. 3.8 Flash es el mejor del nivel gratuito; 4 Argon es el más capaz pero solo de pago; los Flash-Lite son rápidos y baratos pero menos fiables para crear escenas. |
| Modelo del enrutador | select | Sí | Clasifica cada mensaje del chat antes de la respuesta y debe contestar en menos de 20 segundos: lo mejor es un modelo pequeño y rápido. |
| Identificador del otro modelo | string | No | Solo para «Otro modelo»: el identificador exacto de un modelo de Gemini (un modelo más reciente, una versión preliminar…). Debe poder llamar a funciones. |
| Razonamiento del modelo del chat | select | Sí | Más razonamiento da mejores escenas pero respuestas más lentas y caras. Gemini no puede dejar de razonar: mínimo es lo menos, y 3.8 Flash y 4 Argon empiezan en bajo. |
| Longitud máxima de una respuesta (tokens) | number | No | El razonamiento también cuenta. Auméntela si los registros indican que una respuesta ha alcanzado max_tokens; Google aconseja 32768 para 4 Argon. |
Cómo instalar Google Gemini en Gladys
- En Gladys, abre Integraciones: Google Gemini aparece en el catálogo junto a las integraciones nativas, con una insignia de comunidad.
- Haz clic en Instalar. Gladys descarga la imagen Docker (
ghcr.io/william-de71/gladys-google-gemini:0.1.0), la ejecuta en un entorno aislado del núcleo y genera la interfaz de la integración (dispositivos, descubrimiento y configuración). - Abre la pantalla de Configuración de la integración, rellena los parámetros y guarda.
- También puedes instalarla directamente desde la URL de su repositorio: https://github.com/William-De71/gladys-google-gemini.
Google Gemini requiere Gladys >=5.3.0. El catálogo de Gladys se actualiza cada hora, así que una nueva versión está disponible como máximo una hora después de publicarse.
¿Todavía no usas Gladys? Es gratuito y de código abierto: sigue la guía de instalación para empezar.
Sobre las integraciones externas
Google Gemini es una integración externa: una integración comunitaria empaquetada como contenedor Docker y publicada en GitHub. Gladys la instala con un clic y la ejecuta en un entorno aislado del núcleo. La publica y mantiene William-De71, no el equipo principal de Gladys.
- Explorar todas las integraciones, nativas y de la comunidad
- Crear y publicar tu propia integración externa
- Código fuente en GitHub — fuente de esta documentación