DuckDB: ¡rendimiento extremo y una base de datos un 97 % más ligera!
Hola a todos:
Hoy es un gran día: publico una versión mayor de Gladys que va a mejorar drásticamente la experiencia con Gladys y nos mantendrá a la vanguardia de la tecnología de almacenamiento de datos.
Imagina...
➡️ Tu base de datos de Gladys pasa de 47 GB a 1,5 GB...
➡️ Tus gráficas se muestran al instante, incluso con periodos de datos largos...
➡️ Tus copias de seguridad de Gladys Plus son más ligeras y rápidas...
¡Pues lo hemos conseguido!
La tecnología: DuckDB
DuckDB es un sistema de base de datos OLAP que, como SQLite, almacena los datos en un único archivo.
Si tuviéramos que definir DuckDB:
DuckDB es un motor de base de datos analítica diseñado para ofrecer un rendimiento óptimo con grandes volúmenes de datos sin dejar de ser ligero y fácil de integrar. Está especialmente indicado para el análisis de datos embebido, con soporte nativo para consultas SQL complejas y un procesamiento en memoria eficiente.
DuckDB, con su enfoque OLAP + archivo, es único en su género, y llevaba varios años siguiendo de cerca esta tecnología.
Hasta hace poco, DuckDB estaba en fase alfa y, por tanto, no estaba listo para usarse en producción en un producto crítico como Gladys.
Pero en junio, DuckDB alcanzó por fin la versión 1.0, con el anuncio claro de que la API y el formato de archivo ya no sufrirían cambios importantes, lo que hace que DuckDB sea apto para producción.
La integración en Gladys
Tras el lanzamiento de la versión 1.0, empecé enseguida el desarrollo en Gladys e hice un directo en YouTube para probar la tecnología con la comunidad.
Vimos rápidamente juntos que la tecnología era muy prometedora, así que seguí con el desarrollo.
En resumen, las tareas incluían:
- Migrar el historial de sensores que actualmente está en SQLite a DuckDB (y, si era posible, sin tiempo de inactividad)
- Crear una interfaz para seguir la migración y una forma de "limpiar" la base de datos SQLite después
- Modificar todo el código que escribe los valores históricos de los sensores
- Reescribir las consultas de visualización de las gráficas del panel
- Revisar todo el proceso de copia de seguridad de Gladys Plus
- Y, por último, probar la migración en condiciones reales para ver si DuckDB funciona bien en el día a día en instancias reales.
En resumen, ¡había mucho trabajo por hacer!
El resultado
El 6 de agosto empecé las pruebas "reales" en mi instalación personal de Gladys.
Mi instancia tiene unos cuarenta dispositivos y está en funcionamiento desde febrero de 2024.
Tenía una base de datos de 905 MB, con 996.000 estados de sensores, que tras la migración se redujo a:
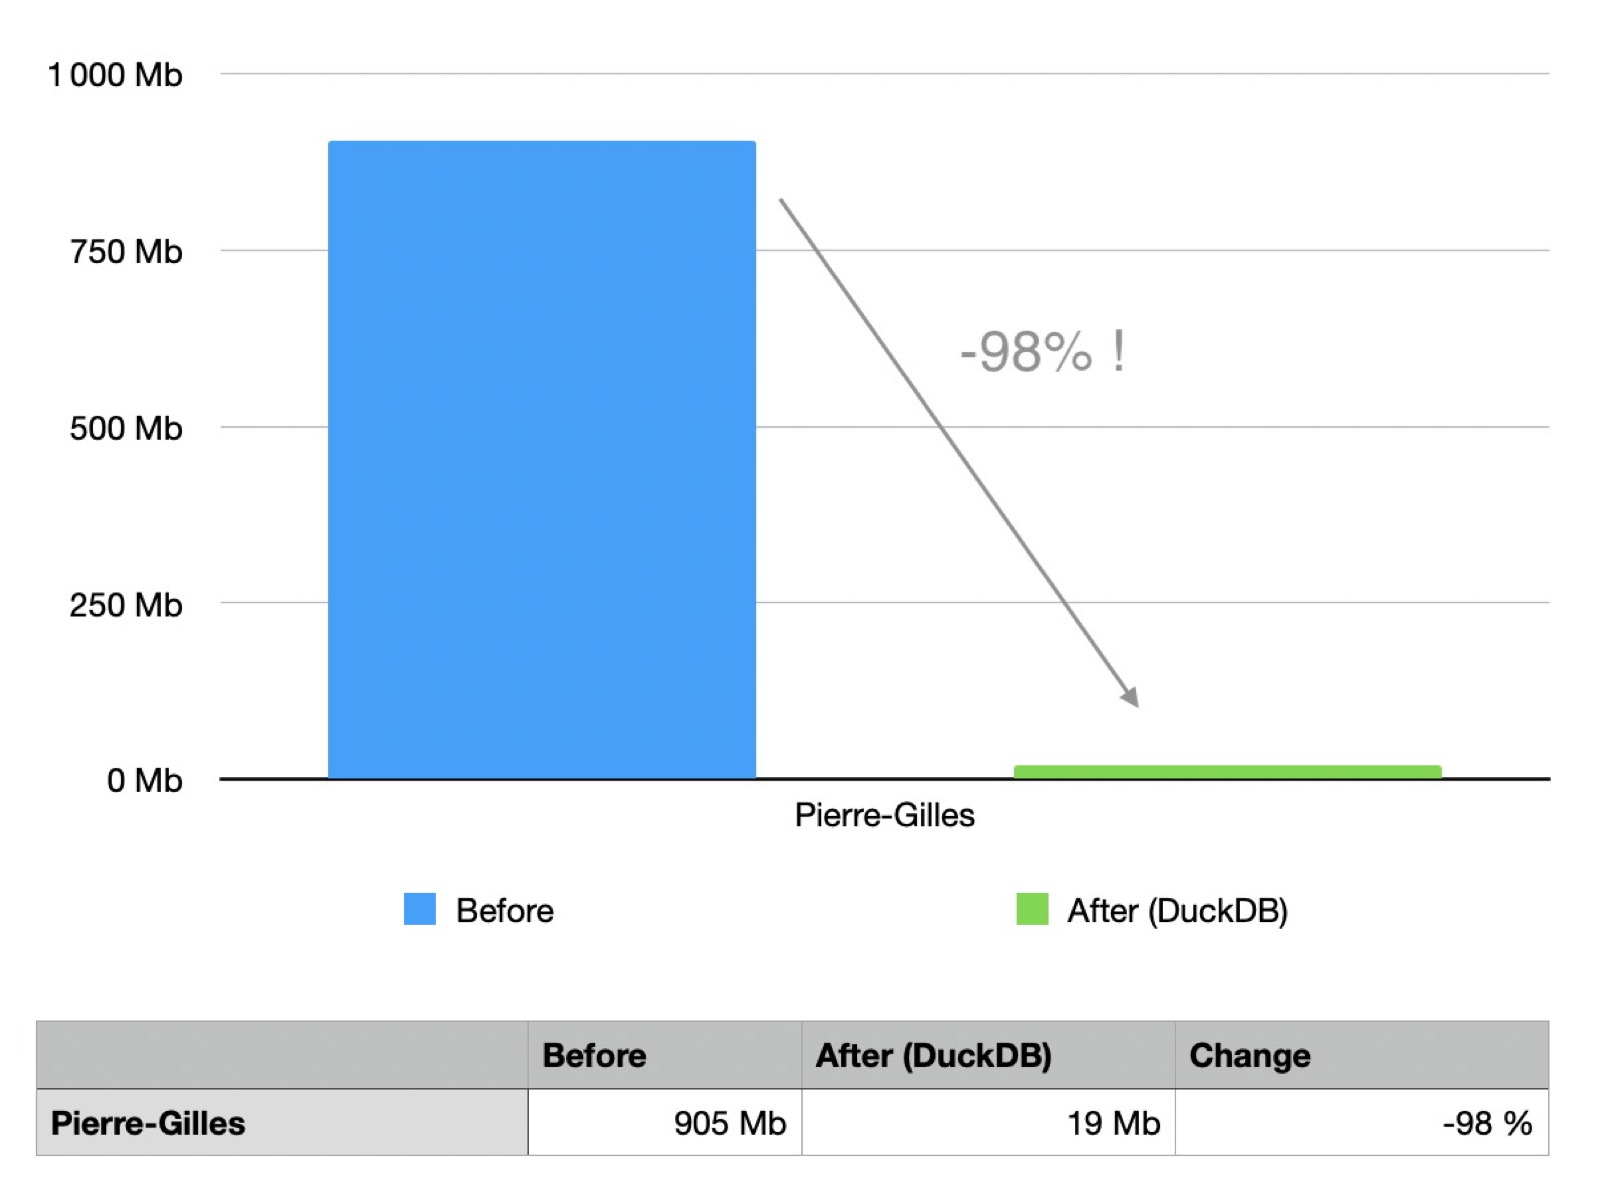
Sí, has leído bien: ¡mi base de datos se redujo a 19 MB! ¡Es casi ridículo!
En el caso del mayor usuario de Gladys, Terdious, con 80 millones de estados en una base de datos de 47,7 GB, se redujo a:
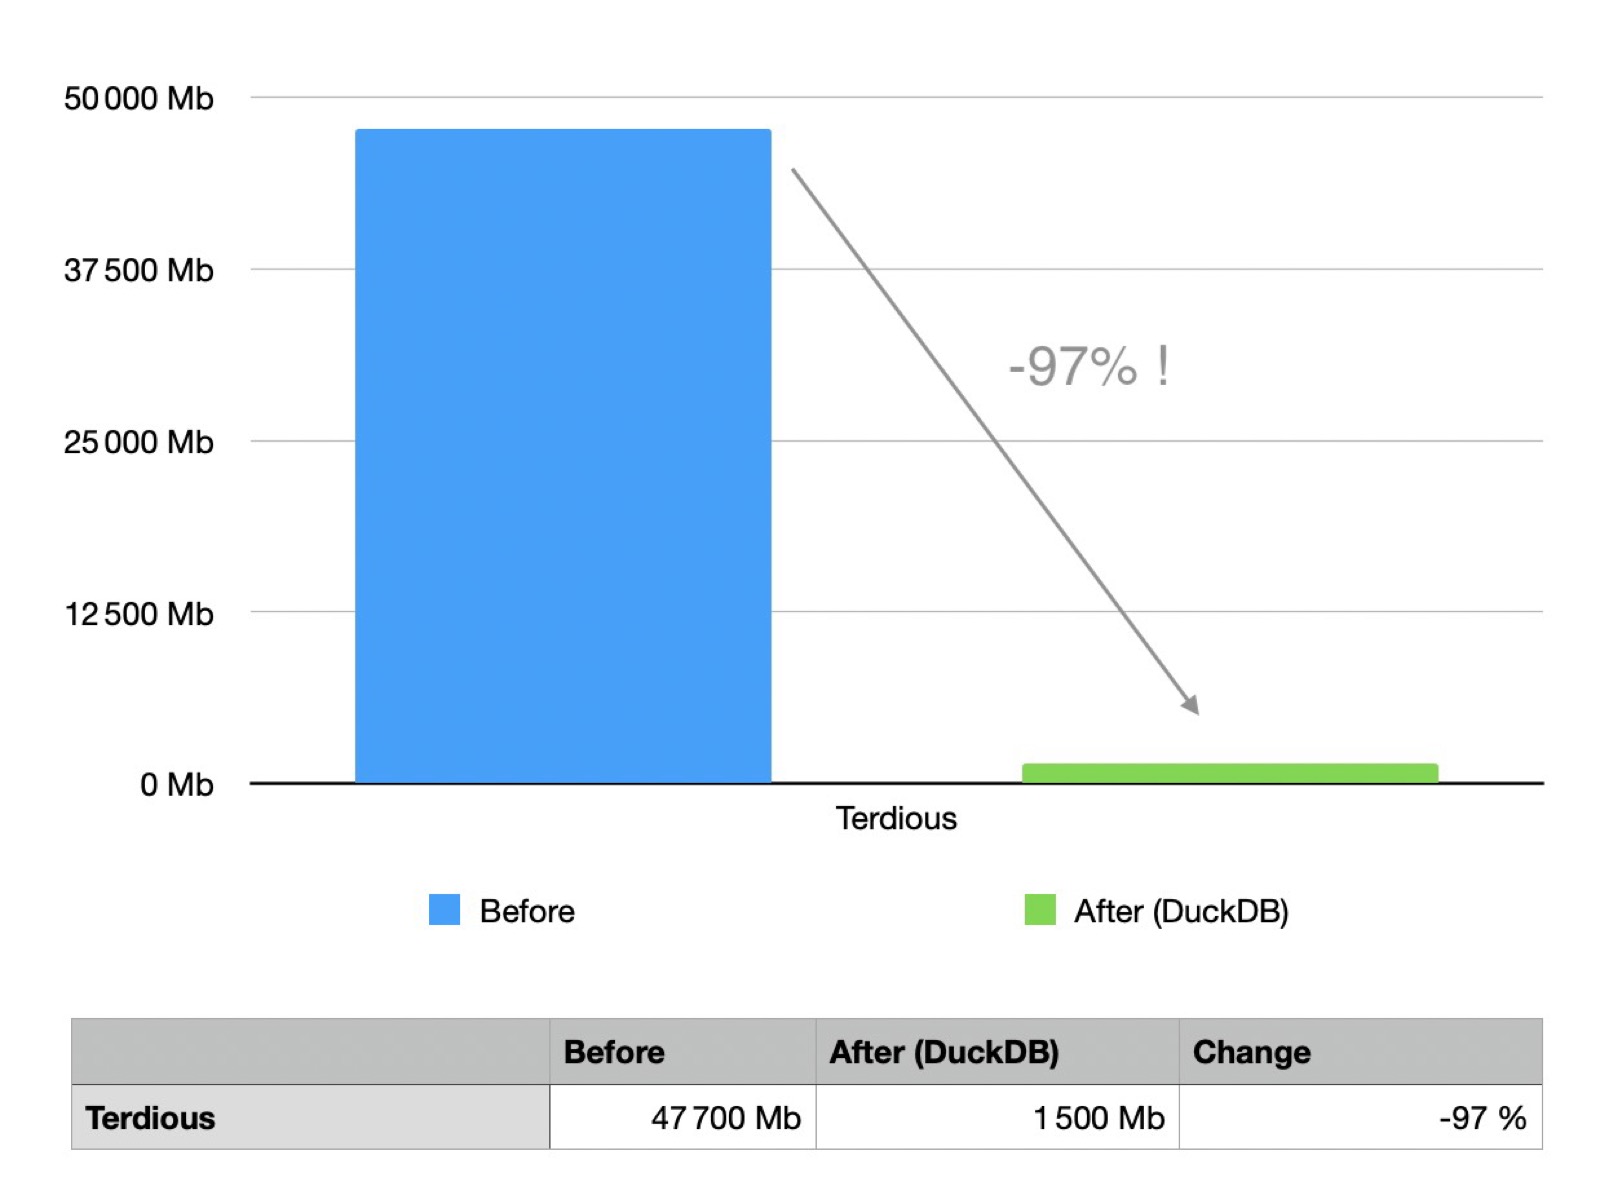
En resumen, ¡es bastante revolucionario!
Desde hace 20 días, esta nueva versión funciona sin problemas en mi instalación y en las de otros usuarios de Gladys.
Las gráficas son mucho más rápidas: Terdious ha notado tiempos de carga dos veces más rápidos en su mini-PC.
En su Pi 4 es todavía más impresionante: los paneles con gráficas se muestran ahora en 150 ms, frente a entre 1 y 5 segundos antes.
¿Cómo funciona por dentro?
Llegados a este punto, quizá te preguntes: ¿es magia?
En realidad, no tanto:
- Para empezar, SQLite no está pensado para este caso de uso, así que nos veíamos obligados a almacenar la información 4 veces en la base de datos: una vez para los datos "en bruto", otra para los datos agregados por mes, otra para los agregados por día y otra para los agregados por hora. Esto nos permitía obtener los datos más rápidamente a partir de conjuntos de datos ya reducidos.
- Además, en SQLite había añadido índices muy específicos para responder a consultas del tipo "Muéstrame los valores del sensor de temperatura XX entre esta mañana y ahora". Estos índices multicolumna ofrecían un buen rendimiento, pero ocupaban mucho espacio (de nuevo, es redundancia).
- Por último, DuckDB hace un trabajo excepcional. Los datos se comprimen de forma agresiva (si te interesa, hay un artículo en su blog).
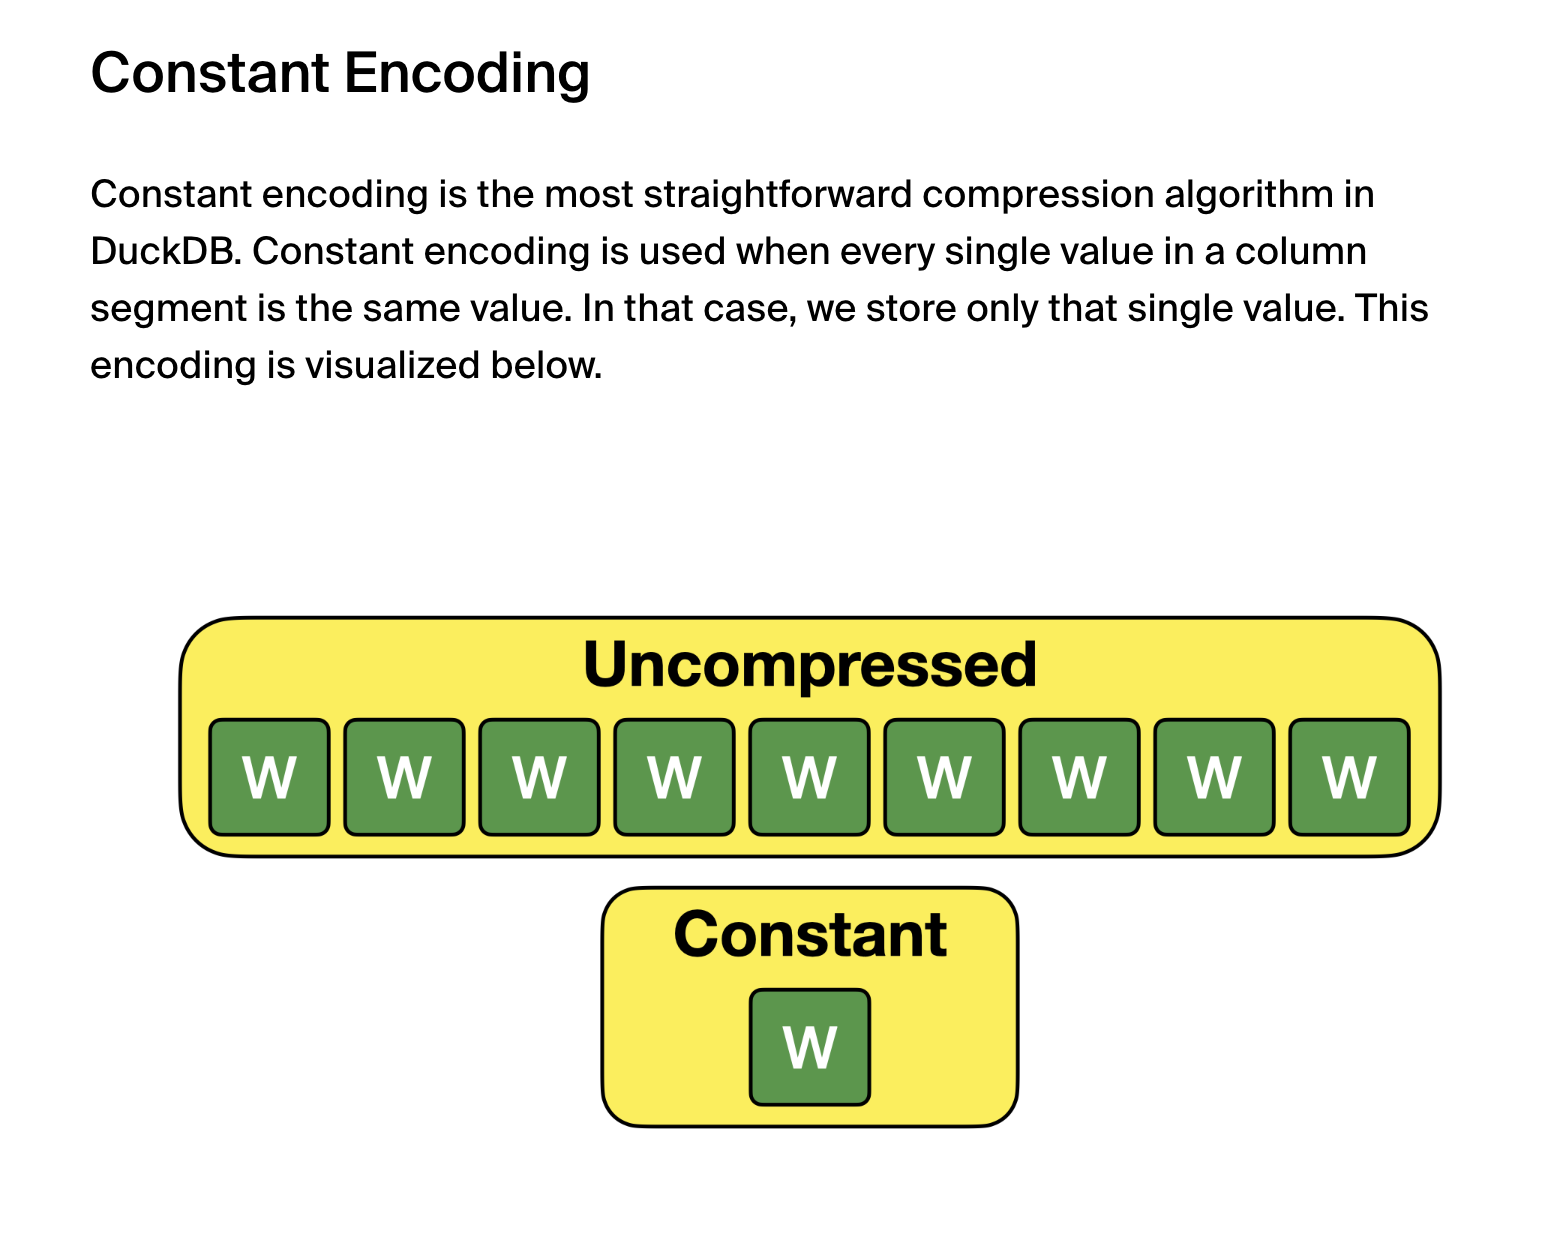
Por ejemplo, en el caso de Gladys, si tienes un sensor binario (sensor de apertura de puerta, sensor de movimiento, sensor de fugas, etc.), los datos son solo 0 y 1: solo hay 2 valores posibles.
Este tipo de conjunto de datos es muy fácil de comprimir:
¿Cómo actualizar?
Normalmente, Gladys debería actualizarse automáticamente si usas Watchtower.
Si instalaste Gladys con Docker, asegúrate de usar Watchtower. Consulta la documentación.
Si eres impaciente y sabes lo que haces, también puedes ejecutar Watchtower manualmente en modo "one-shot":
docker run --rm \
    -v /var/run/docker.sock:/var/run/docker.sock \
    nickfedor/watchtower \
    --run-once
(No olvides usar sudo si ejecutas Gladys como administrador)
Una vez que Gladys se haya actualizado a la v4.45.0, hay que seguir varios pasos antes de ver cómo se reduce tu base de datos.
La migración
En cuanto tu instancia se actualice, empezará la migración a DuckDB.
En la parte superior de tu panel verás un mensaje:
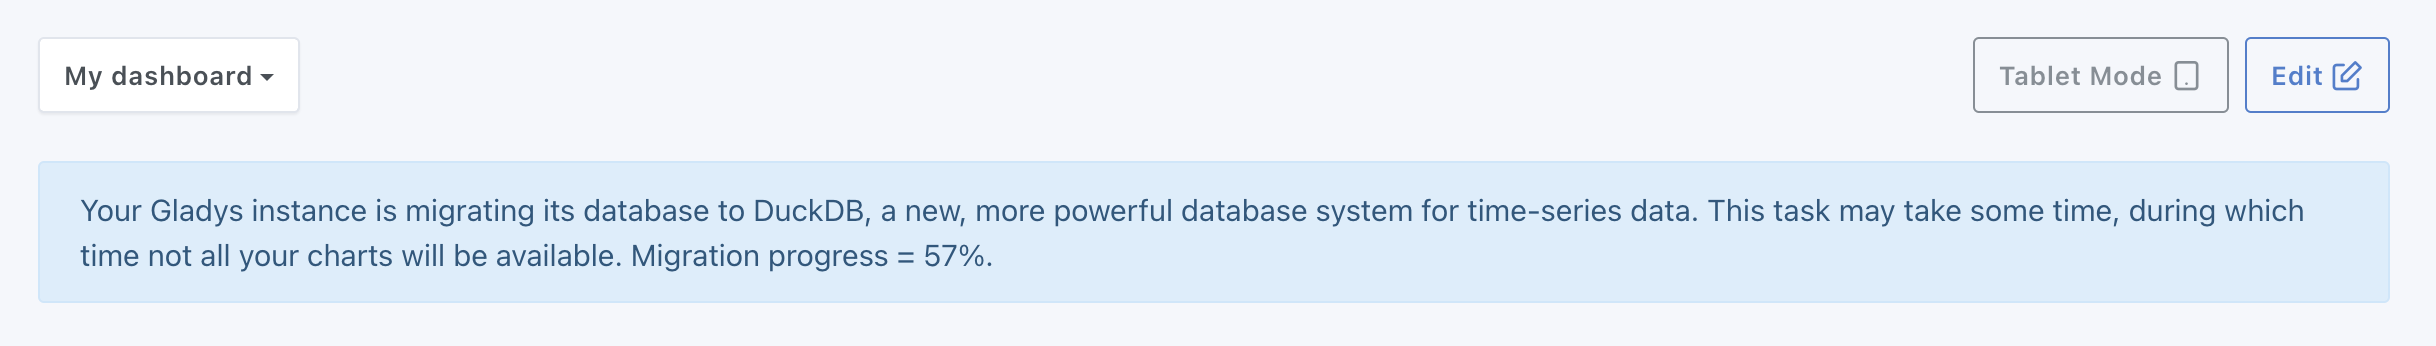
Durante esta migración, tu instancia puede ir más lenta y tus gráficas no estarán disponibles.
Puedes consultar el estado de la migración en "Ajustes → Sistema":
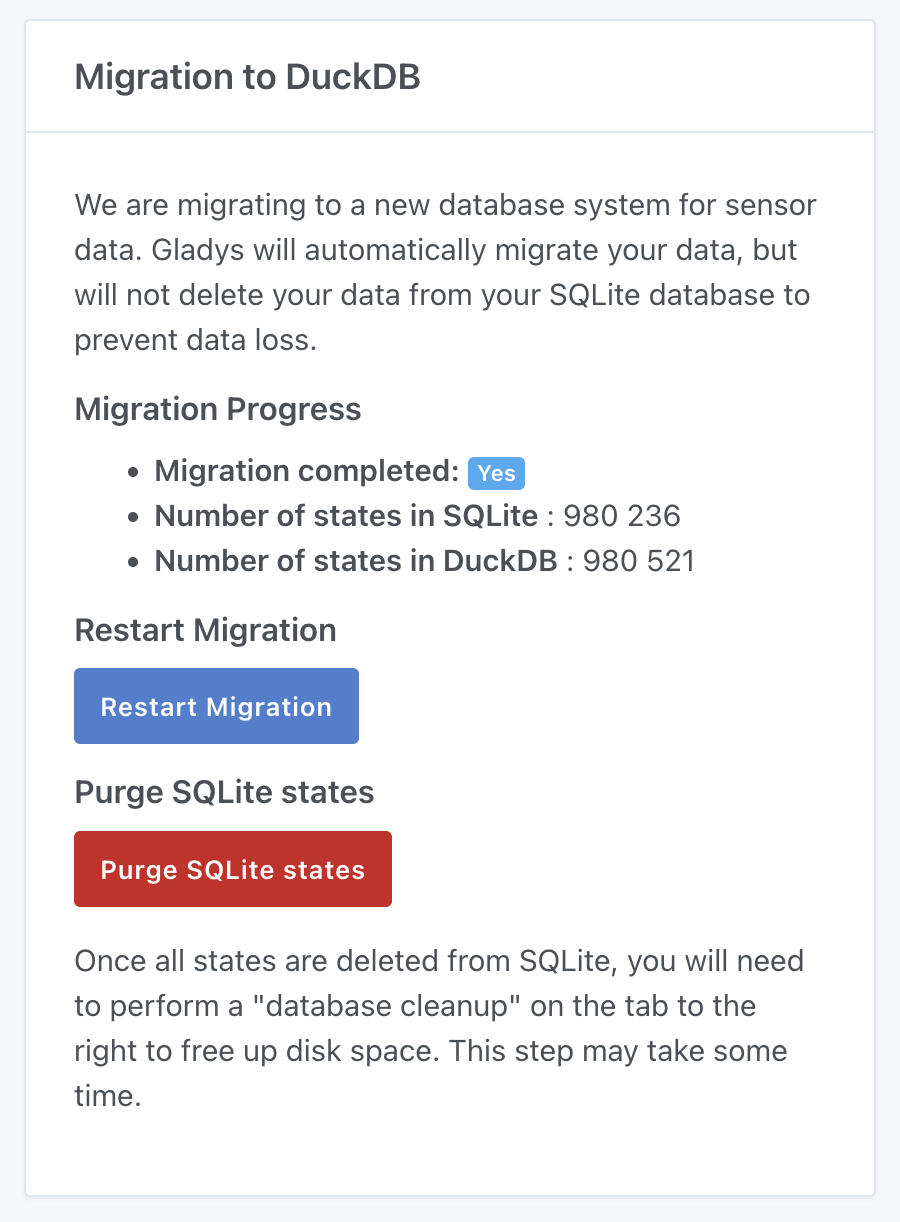
Cuando la migración haya terminado, la línea "Migración completada" pasará de "No" a "Sí".
Tómate un momento para recorrer Gladys y comprobar que todas tus gráficas se ven correctamente.
Si todo está bien, puedes purgar los estados de SQLite haciendo clic en el botón rojo "Purgar los estados de SQLite", que iniciará una tarea:
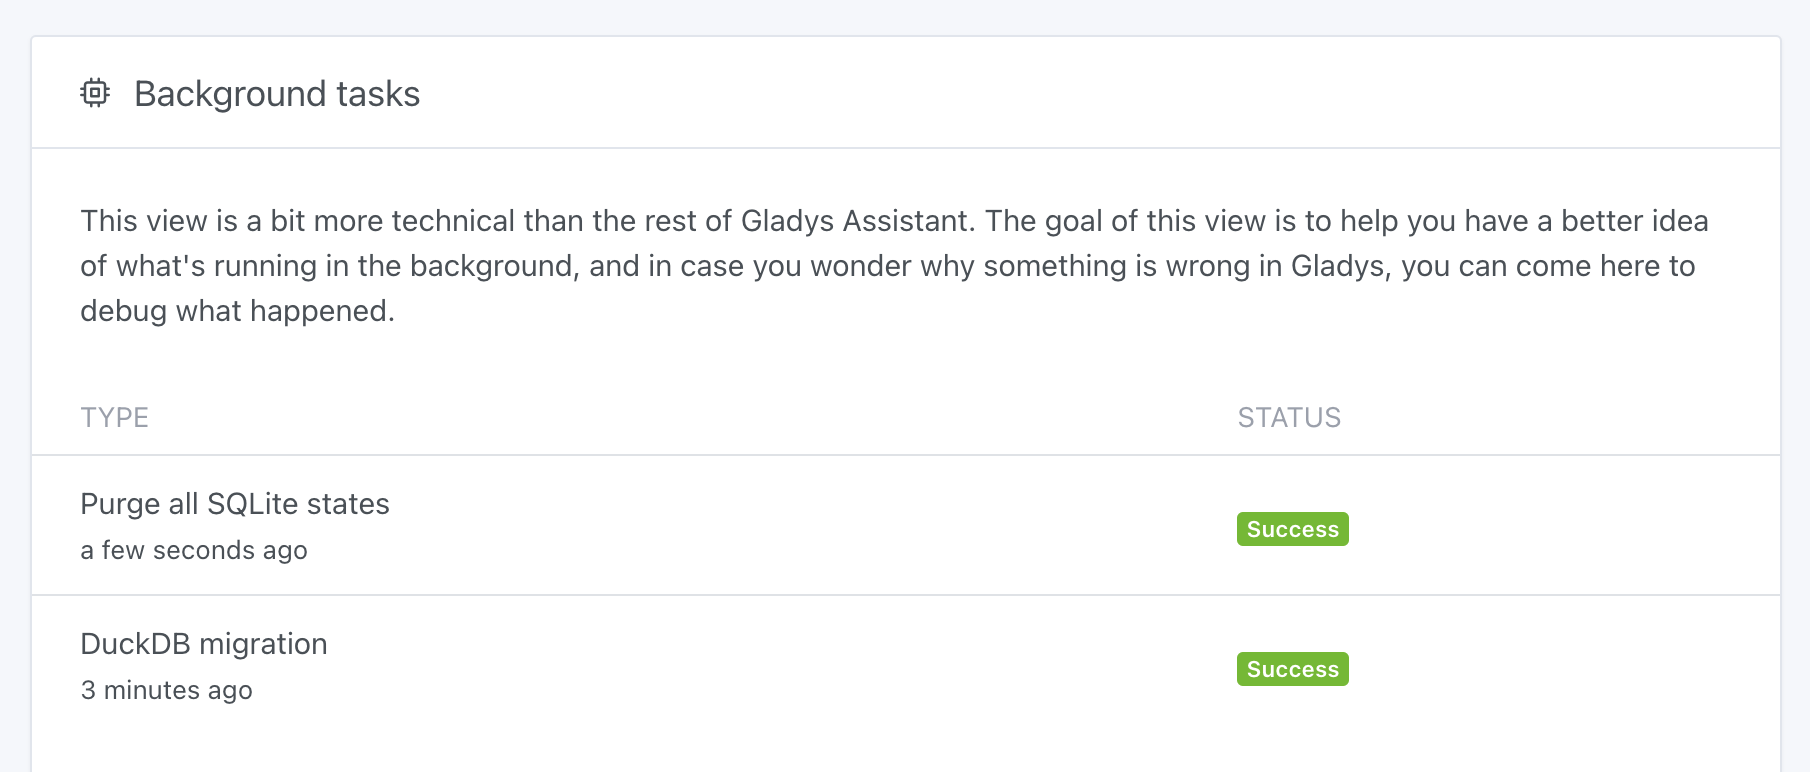
Durante esta tarea, tu instancia de Gladys irá un poco más lenta, es normal.
Según el número de estados de tu base de datos y la velocidad de tu disco, esta tarea puede tardar unas horas o incluso días si tienes una base de datos grande.
Gladys sigue siendo utilizable, ¡pero más lenta!
Por último, una vez terminada esta purga, tendrás que limpiar la base de datos SQLite para que el archivo en tu disco se reduzca por fin.
Para ello, haz clic en el botón "Limpiar la base de datos":
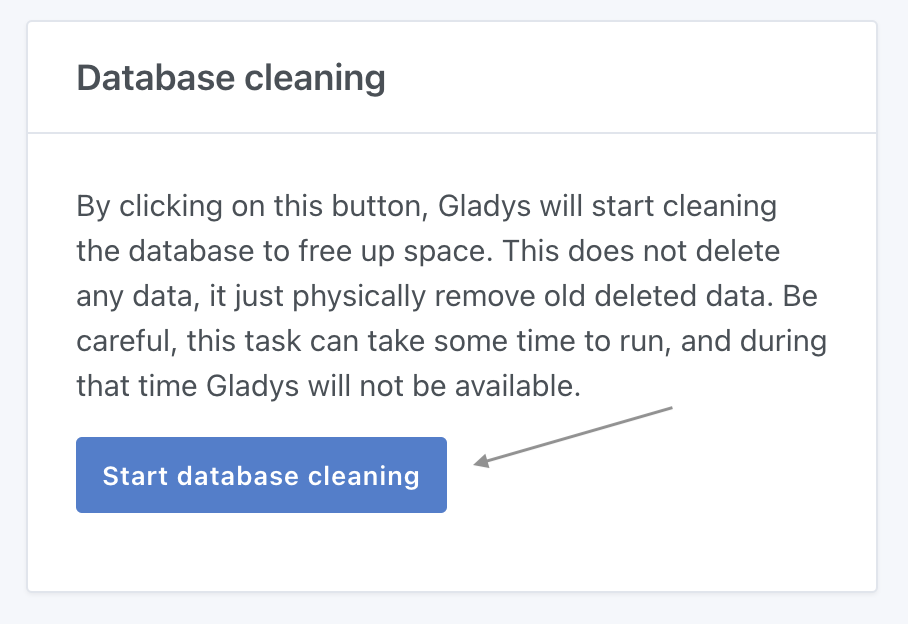
Esta tarea es bloqueante, y Gladys no estará disponible durante la limpieza.
Por último, cuando la tarea haya terminado, reinicia Gladys.
¡Listo! ¡Ahora deberías tener una base de datos mucho más pequeña y una instancia de Gladys mucho más rápida!
Conclusión
¡Espero que esta actualización te dé los mismos resultados que a todos los testers!
En cualquier caso, estoy convencido de que esta actualización va a revolucionar el uso de Gladys, y tus comentarios serán bienvenidos.
Gracias de nuevo a todos los testers que han ayudado en el desarrollo 🙏
Apoyar el proyecto
Hay muchas formas de apoyar el proyecto:
- Participa en las conversaciones del foro y ayuda a los recién llegados.
- Contribuye al proyecto proponiendo nuevas integraciones o funciones.
- Mejora la documentación, que es de código abierto.
Gracias a todos los que apoyan a Gladys 🙏